Im AI Department entwickelst du die kognitiven Fähigkeiten unserer Roboter und bringst sie dazu, die Welt um sie herum zu verstehen und darauf zu reagieren. Du arbeitest an den Algorithmen, die Maschinen intelligent und adaptiv machen – von Objekterkennung über Sprachverarbeitung bis hin zu Entscheidungsfindung in komplexen Umgebungen. Hier bist du Teil eines Teams, das technologische Grenzen verschiebt und eng mit anderen Bereichen wie Software, Hardware und Produktmanagement zusammenarbeitet. Mit modernsten Tools und Methoden aus Machine Learning und KI arbeitest du an Projekten, die direkt in unseren Produkten sichtbar werden. Wenn du begeistert bist von der Idee, Maschinen intelligenter zu machen und damit die nächste Stufe der Mensch-Maschine-Interaktion zu gestalten, bist du im AI Department genau richtig.

Compute Infrastructure Engineer – NeuraGym (Mensch)
Neura Robotics • Riederich
Gib unseren Robotern ein Bewusstsein
-
Vollzeit
Riederich
Als Compute Infrastructure Engineer – NeuraGym arbeitest du an der Schnittstelle von Serverarchitektur, Virtualisierung, Container-Orchestrierung und Datenverarbeitung, mit besonderem Fokus auf den Aufbau einer skalierbaren Compute- und Storage-Infrastruktur für multimodale Robotikdaten. Deine Kernaufgabe ist es, die Systemlandschaft im NeuraGym zu entwerfen, aufzubauen und zu betreiben, damit Aufzeichnung und Verarbeitung großer Datenmengen zuverlässig, performant und reproduzierbar ablaufen.
Du spielst eine entscheidende Rolle bei der Entwicklung hochwertiger Embodied-AI-Systeme, indem du einzelne Server, Workstations und Edge-Geräte zu einem verteilten, wartbaren und erweiterbaren Compute-System verbindest.
-
Infrastruktur-Planung: Du planst und dimensionierst die Serverinfrastruktur des NeuraGym, inklusive Compute, GPU, Storage und Netzwerk, Rack-Layout, Strom- und Kühlkonzept sowie Beschaffung in Abstimmung mit dem Team.
-
Virtualisierung: Du baust und betreibst Virtualisierungsumgebungen auf Basis von Hypervisoren wie Proxmox und stellst Entwicklungs-, Test- und Produktivumgebungen bereit.
-
Kubernetes & GPU-Scheduling: Du entwirfst und betreibst Kubernetes-Cluster (oder vergleichbare Orchestrierung) für Datenvorverarbeitung, inklusive GPU-Scheduling, Monitoring und Logging.
-
Verteilte Verarbeitung: Du verteilst rechen- und datenintensive Prozesse intelligent über mehrere Maschinen, vom Edge-Gerät am Roboter über lokale Server bis zu zentralen Storage-Systemen, und sorgst dafür, dass Engpässe erkannt und beseitigt werden.
-
Netzwerk-Design: Du entwirfst die Netzwerkinfrastruktur des NeuraGym: VLANs, Switching, Bandbreitenplanung für Kamera- und Sensorstreams, Firewall-Regeln und sichere Integration in die restliche Unternehmens-IT.
-
Storage & Datenpipelines: Du baust Storage- und Datenpipelines für große Datenmengen (z. B. Object Storage, verteilte Dateisysteme, Streaming-Ingest) und stellst sicher, dass Daten zuverlässig erfasst, gespeichert, versioniert und für das Modelltraining verfügbar sind.
-
Automatisierung: Du automatisierst Provisioning, Deployment und Betrieb mit Infrastructure-as-Code und CI/CD-Tools und dokumentierst die Systemlandschaft nachvollziehbar.
-
Stabilität & Sicherheit: Du erkennst und löst Performance-, Stabilitäts- und Sicherheitsprobleme in der Infrastruktur und entwickelst Backup-, Recovery- und Zugriffskonzepte.
-
Ausbildung: Abschluss in Informatik, Systemtechnik, Ingenieurwesen oder einem verwandten Fachgebiet, oder eine vergleichbare Berufsausbildung mit einschlägiger Praxiserfahrung.
-
Erfahrung: 4+ Jahre Erfahrung in System Administration, Infrastructure Engineering, DevOps oder Platform Engineering.
-
Serverinfrastruktur: Solide Erfahrung in Planung, Design und Betrieb von Serverinfrastruktur (Dimensionierung, Rack-Aufbau, Hardware-Auswahl, Beschaffung).
-
Virtualisierung: Praktische Erfahrung mit Hypervisoren und Virtualisierung (z. B. Proxmox, KVM, VMware), inklusive Storage- und Netzwerkintegration.
-
Container: Fundierte Kenntnisse in Container-Technologien und Orchestrierung (Docker, Kubernetes oder vergleichbare Plattformen), idealerweise mit GPU-Workloads.
-
Verteilte Systeme: Verständnis dafür, wie Prozesse, Daten und Rechenlast über mehrere Maschinen hinweg sinnvoll verteilt, synchronisiert und überwacht werden.
-
Linux & Scripting: Sicher im Umgang mit Linux-Systemen, Shell-Scripting und mindestens einer Skriptsprache (z. B. Python, Bash).
-
IaC & CI/CD: Erfahrung mit Infrastructure as Code und Automatisierung (z. B. Ansible, Terraform) sowie mit CI/CD-Tools (z. B. GitLab CI).
-
Arbeitsweise: Eine strukturierte, selbstständige Arbeitsweise und Freude daran, Infrastruktur von Grund auf gemeinsam mit einem interdisziplinären Team aufzubauen.
Nice to have: Erfahrung mit Monitoring- und Logging-Stacks (z. B. Prometheus, Grafana).
Worauf du dich freuen kannst
Gestaltungsfreiheit und Agilität
Leistungsorientierte und eigenverantwortliche Arbeitskultur mit flachen Hierarchien sowie flexiblen Arbeitszeiten und 30 Tagen Erholungsurlaub.
Leidenschaft zu gewinnen
Ein leidenschaftliches und hochqualifiziertes Team aus internationalen Experten, die Roboterassistenten neu definieren wollen.
Attraktive Vergütung
Wettbewerbsfähiges Gehaltspaket plus spezielle Mitarbeiterrabatte.
One Team
Ob Sommerfest oder Firmen-Townhall-Meetings – Erfolge feiern wir gemeinsam.
Weiterentwicklung
Unterstützung bei deiner persönlichen und beruflichen Entwicklung.
Unsere Unternehmenswerte. Die Eckpfeiler unseres Erfolgs.
Wir sind ein Team. Wir streben danach, Großes zu erreichen, indem wir den Erfolg unserer Kollegen und Partner fördern.
Wir streben nach technologischem Fortschritt, um Menschen ihre wertvolle Zeit für angenehme Tätigkeiten zurückzugeben.
Wir sind bestrebt, die Welt der Robotik zu revolutionieren, indem wir die Grenzen der Technologie täglich verschieben.
Durch offene Kommunikation und Transparenz leben wir ein hohes Maß an Wertschätzung.
Wir geben unser Bestes immer zwei Schritte voraus zu sein. Dies erreichen wir durch Empowerment, Handlungsfreiheit und Eigenverantwortung.
Der Mensch steht im Mittelpunkt all unseren Handelns.
Unser Standort
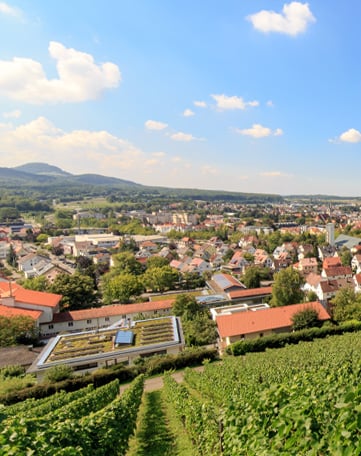
Unsere Headquarters in Metzingen und in Riederich sind das Herz unseres Unternehmens. Hier befinden sich nicht nur unsere Büros, sondern auch die Produktion, die Academy, die Logistik und die Tech Labs – alles vereint, um Ideen Wirklichkeit werden zu lassen. Riederich selbst ist ein kleiner, ruhiger Ort, nur einen Kilometer entfernt von Metzingen, einer Stadt mit ganz eigenem Charakter.
Metzingen ist weltweit als Outlet City bekannt und zieht Menschen aus aller Welt an. Hier kannst du exklusive Designerläden in einer entspannten, charmanten Umgebung genießen. Gleichzeitig bietet die Stadt Restaurants, Cafés und eine bodenständige schwäbische Gemütlichkeit – ideal, um nach der Arbeit zu entspannen.
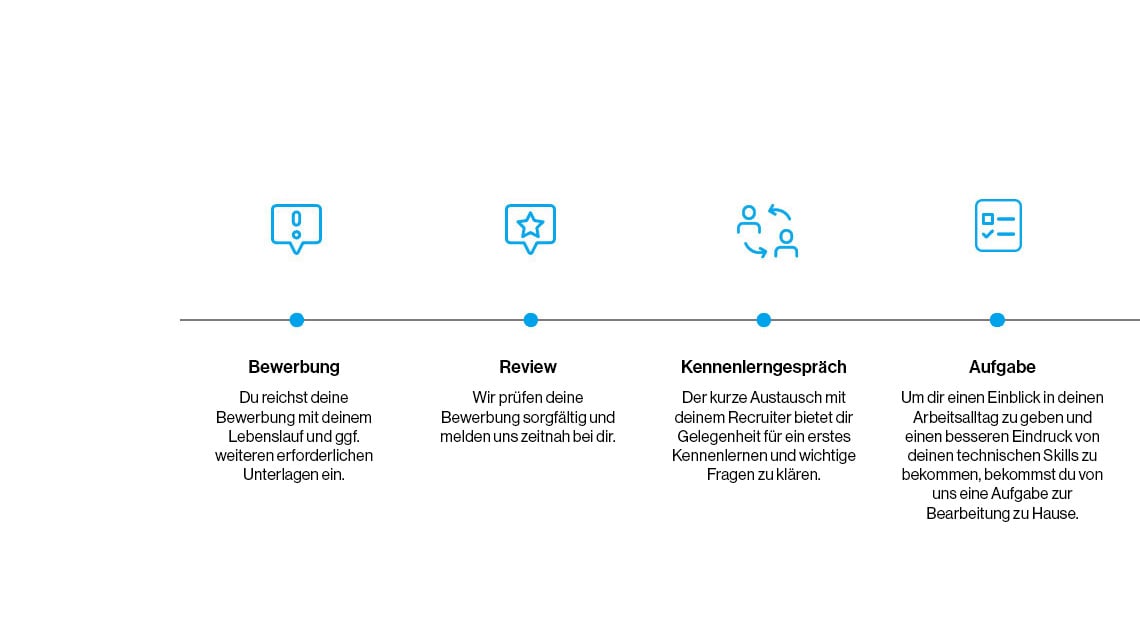
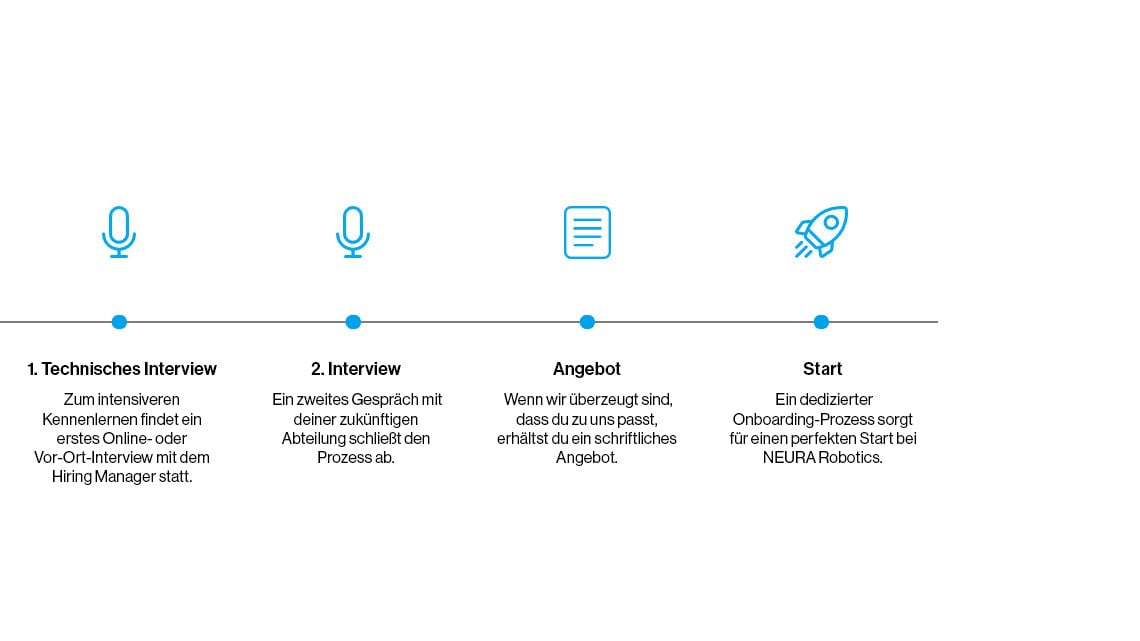
Bewerbungsprozess
Wir sorgen für einen transparenten und effizienten Ablauf und freuen uns darauf, dich während des Bewerbungsprozesses kennenzulernen.
Dein Blick in den Arbeitsalltag


Unsere Mission
Unser Ziel war es, den weltweit ersten kognitiven Roboter zu entwickeln, der mit Menschen arbeiten, von ihnen lernen und sie so zielgerichtet unterstützen kann. Genau das haben wir erreicht. Aber es kommt noch viel mehr!
